
Google ha presentato Gemini 4 Argon, modello di IA di punta che ha definito capace di sostenere ragionamenti e sequenze di lavoro molto lunghe, dalla programmazione alla ricerca finanziaria e legale, passando per la cyber difesa.
Il lancio, però, porta con sé una certa tensione. Infatti, mentre Google descrive Argon come un salto di qualità, alcuni dipendenti con accesso diretto al modello lamenterebbero una certa distanza tra gli ottimi risultati nei benchmark e ciò che accade in una parte del lavoro quotidiano, soprattutto nel coding.
Da una parte ci sono i risultati restituiti dai benchmark, ossia dai test standardizzati usati per confrontare i modelli su compiti definiti, dall’altra parte i dubbi sollevati dai dipendenti di Google che hanno avuto modo di usare il nuovo modello IA.
Tutto ciò in un momento in cui, per Google, la posta in gioco è particolarmente alta, perché la famiglia di modelli Gemini viene progressivamente integrata nella ricerca online, in Android e nei servizi dell’azienda, prendendo in mano il testimone lasciato da Google Assistant e guardando a una base utenti di centinaia di milioni tra persone e organizzazioni.
Un modello costruito per lavorare più a lungo
Una delle novità più importanti di Gemini 4 Argon è la capacità di produrre risposte molto più lunghe, spostando il limite massimo da 64mila a un milione di token per singola generazione. Un token è una delle unità in cui il modello scompone il testo e aumentare il numero che può produrne consente, almeno in teoria, di portare avanti attività molto più estese senza spezzarle in decine di passaggi separati. L’obiettivo è gestire migrazioni di grandi basi di codice, analisi di documenti articolati, ricerche e agenti IA che devono eseguire molte operazioni in sequenza.
Google sostiene che Argon è già utilizzato internamente da migliaia di dipendenti e che è stato impiegato per l’ottimizzazione di algoritmi per il calcolo quantistico, per la gestione dei data center, per la migrazione di grandi basi di codice dai linguaggi C e C++ al linguaggio Rust.
Tra i casi citati da BigG per mettere in evidenza le capacità di Gemini 4 Aragon, c’è anche il lavoro su oltre 800mila righe di Zircon, il cuore del sistema operativo Fuchsia di Google. Per correttezza, è bene sottolineare che sono risultati dichiarati dall’azienda e non verificati in modo indipendente.
I benchmark premiano Argon, ma il quadro sul coding è meno lineare
Sul lavoro professionale i dati pubblici sono rilevanti. Nel benchmark Vals Index, che aggrega compiti di finanza, programmazione, diritto e fiscalità pesandoli sul contributo dei diversi settori al Pil statunitense, Gemini 4 Argon risulta primo con il 68,9%. Google, inoltre, rivendica il 77,9% su DeepSWE v1.1, un test dedicato a lavori di ingegneria del software di lunga durata, e il primo posto su AutomationBench, che misura l’esecuzione di attività aziendali.
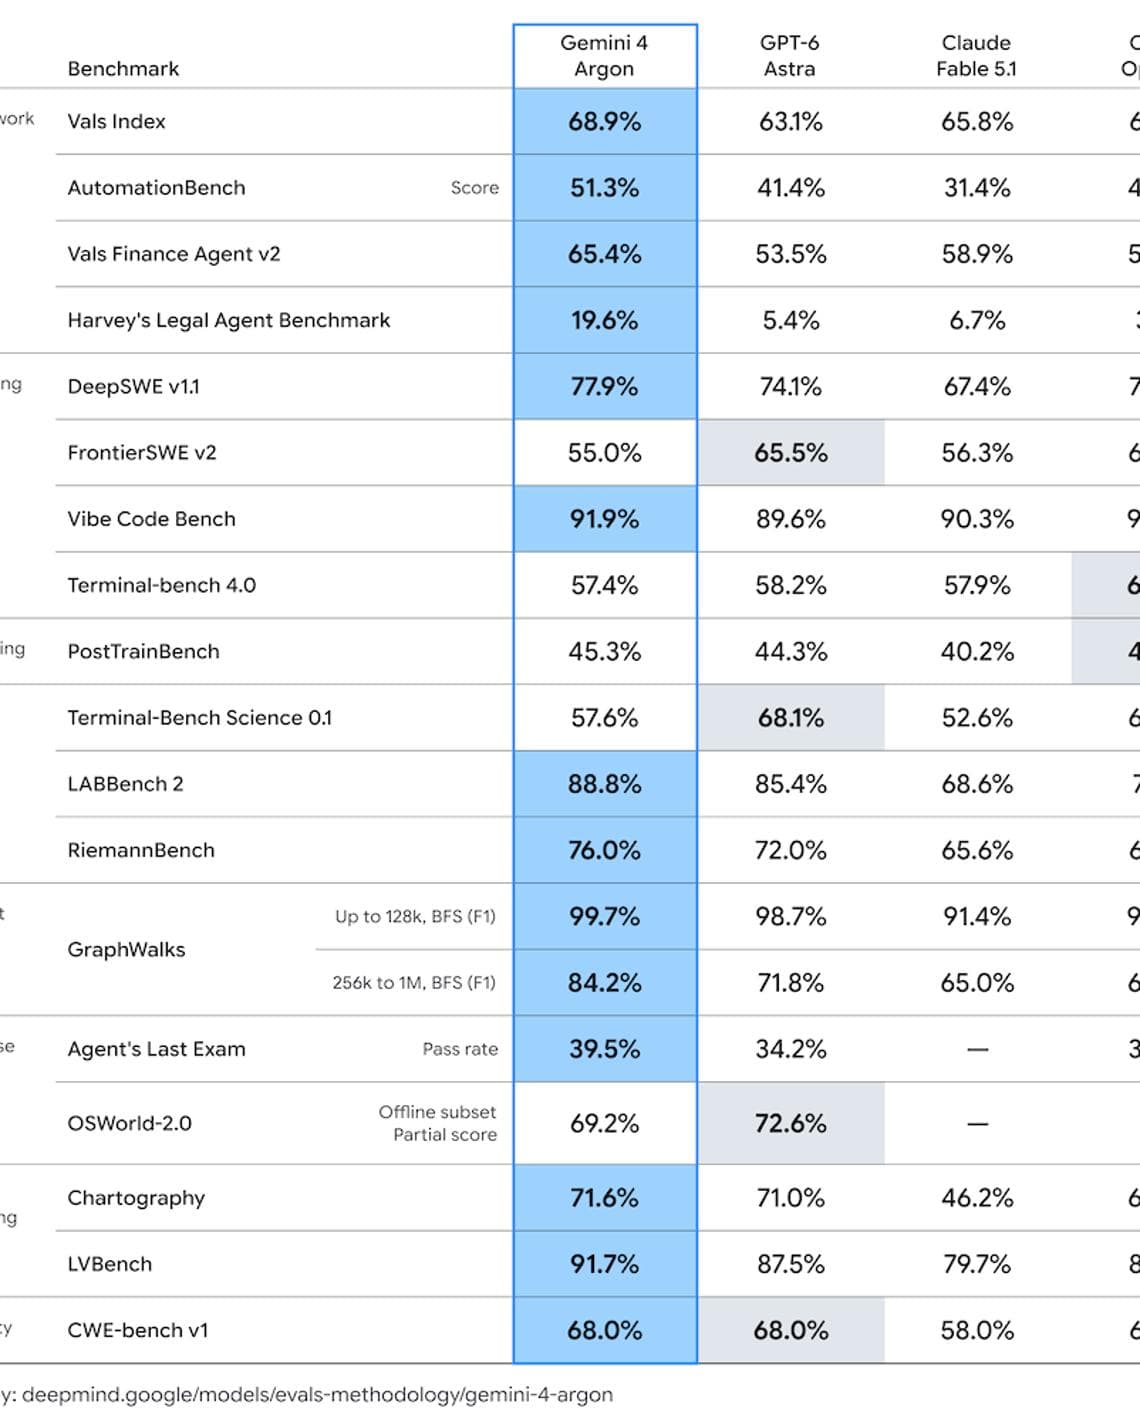
La stessa tabella di lancio, però, mostra che Argon non domina ogni prova di programmazione. Su FrontierSWE v2 ottiene il 55% per cento, contro il 65,5% di Gpt-6 Astra di OpenAI e il 62,3 per cento di Claude Opus 5.5 di Anthropic.
Su Terminal-bench 4.0, che valuta la capacità di completare attività attraverso la riga di comando, Argon arriva al 57,4%, mentre Claude Opus 5.5 raggiunge il 66,4%.
Una prima verifica esterna è già disponibile. Artificial Analysis colloca Argon tra i modelli di vertice nel proprio Intelligence Index e ne sottolinea il rapporto tra capacità e costo. Anche in questo caso, però, il punto decisivo resta l’uso reale, perché un punteggio aggregato aiuta a orientarsi, mentre la qualità su un progetto software dipende da linguaggio, strumenti, durata del compito, capacità di correggere errori e affidabilità delle azioni.
I dubbi
Secondo persone che hanno accesso diretto allo sviluppo, Gemini 4 avrebbe prestazioni convincenti nei benchmark ma più irregolari quando viene impiegato in alcune attività reali di programmazione. Una delle fonti citate da Bloomberg indica come punto debole il front-end design, cioè la parte dello sviluppo che determina aspetto, interazione e comportamento visibile di siti e applicazioni.
Google contesta questa ricostruzione. L’azienda ha risposto a Bloomberg che sarebbe inesatto descrivere Gemini 4 come un modello che sottoperforma nel coding e ha richiamato le valutazioni positive di Koray Kavukcuoglu, oggi alla guida operativa di Google DeepMind. Un altro dipendente citato da Bloomberg parla di un ampio consenso interno sul fatto che Gemini 4 sia ormai alla frontiera delle capacità. Le due versioni non sono necessariamente incompatibili, giacché un modello può essere competitivo nel complesso e mostrare debolezze specifiche in alcuni flussi di lavoro.
La priorità alla cybersicurezza e il programma Fairwind
Per ora Argon non è un modello aperto al pubblico. Google lo sta distribuendo attraverso il Fairwind Program, un programma che concede accesso anticipato a organizzazioni considerate ad alta priorità per la difesa digitale, tra le quali enti pubblici, operatori di infrastrutture critiche, sanità, telecomunicazioni e grandi piattaforme tecnologiche.
Per i partner fidati Google prevede una versione senza i normali filtri cyber, in modo da permettere attività difensive complete. Sul CWE-bench v1, un benchmark che simula audit di sicurezza su repository reali senza indicare in anticipo quale vulnerabilità cercare, Argon ottiene il 68%, a pari merito con Grok 4.7 e GPT-6 Astra.
Il tema si inserisce in un contesto delicato, peraltro riconosciuto anche dalla stessa Google, che ha messo l’accento sul fatto che le IA possono aumentare le capacità e la potenza di fuoco del cyber crimine.
Gemini 4 Argon rende il problema più concreto, poiché a maggiore autonomia nella ricerca e nella correzione delle falle, corrisponde anche maggiore attenzione su chi può usare il modello e con quali controlli.
I quattro livelli di sicurezza prima del rilascio più ampio
Google indica quattro aree di protezione prima della diffusione generale. La prima riguarda il rifiuto di richieste dannose in ambito cyber e CBRN, cioè chimico, biologico, radiologico e nucleare. La seconda è la difesa dalle prompt injection indirette, ovvero istruzioni malevole nascoste dentro pagine, documenti o altri contenuti che un agente IA potrebbe leggere e interpretare come comandi legittimi. La terza area è il monitoraggio di possibili comportamenti disallineati, ovvero azioni che superano l’intenzione dell’utente pur di raggiungere un obiettivo. Infine, la quarta area riguarda gli ambienti di esecuzione. DeepMind sta rafforzando sandbox e sistemi isolati, secondo una più ampia strategia di sicurezza per gli agenti introdotta a giugno del 2026. Google afferma inoltre di partecipare a un processo volontario del governo americano per l’accesso pre-rilascio ai modelli.
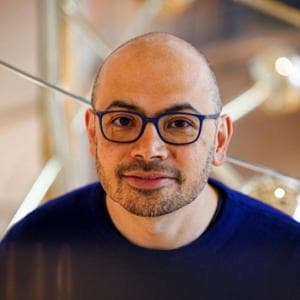
Rimpasto di Google ai vertici di DeepMind, Demis Hassabis lascia il posto a Koray Kavukcuoglu
Prezzo e disponibilità: il pubblico dovrà aspettare
Google prevede per Argon un prezzo introduttivo di 2 dollari per milione di token in ingresso e 10 dollari per milione di token in uscita. Terminata la fase promozionale, stando alla nota ufficiale, i prezzi saliranno rispettivamente a 4 dollari e a 20 dollari.
La cautela sul calendario arriva in una fase di riassetto anche per DeepMind. Infatti, lo scorso mese di agosto la divisione di Big G che si occupa di intelligenze artificiale ha subito un cambio ai vertici e ciò fa di Gemini 4 il primo banco di prova dopo l’avvicendamento dei ruoli apicali.
La vera prova comincia quando finiscono i benchmark
Finché Argon resta nelle mani di Google e di un gruppo ristretto di partner, gran parte del giudizio dipende da benchmark, dimostrazioni controllate e testimonianze interne. Quando arriverà a sviluppatori e aziende sarà possibile misurare ciò che conta davvero e quanto spesso completa un compito senza interventi, quanto costa arrivare a un risultato corretto, come gestisce gli errori e se le sue capacità reggono su progetti che non assomigliano ai test usati per presentarlo.


