Hanno sempre gli stessi nomi. Si chiamano Elena Vasquez, Marcus Chen, Amara Okafor e altri ancora e, oltre a essere luminari in diverse discipline scientifiche – vulcanologia ed esplorazione spaziale incluse – avrebbero preso parte a conferenze e avrebbero firmato studi accademici disponibili online. Il condizionale è d’obbligo, perché gli esperti sono creati dalle IA ma i paper alla cui stesura hanno collaborato sono veramente reperibili su archivi ritenuti attendibili.
È quanto emerge da uno studio condotto dal ricercatore Michał Brzozowski del Samsung AI Center di Varsavia e da Neo Christopher Chung, professore e scienziato dell’Università locale, secondo cui esiste una contaminazione sistematica delle IA nell’editoria scientifica.
La coppia perfetta nata dentro gli algoritmi
I ricercatori hanno esaminato il comportamento dei modelli linguistici di grandi dimensioni (Large language model, LLM) dimostrando che, quando a questi sistemi viene chiesto di inventare figure di esperti senza fornire indicazioni specifiche sul nome, le macchine non scelgono in modo casuale.
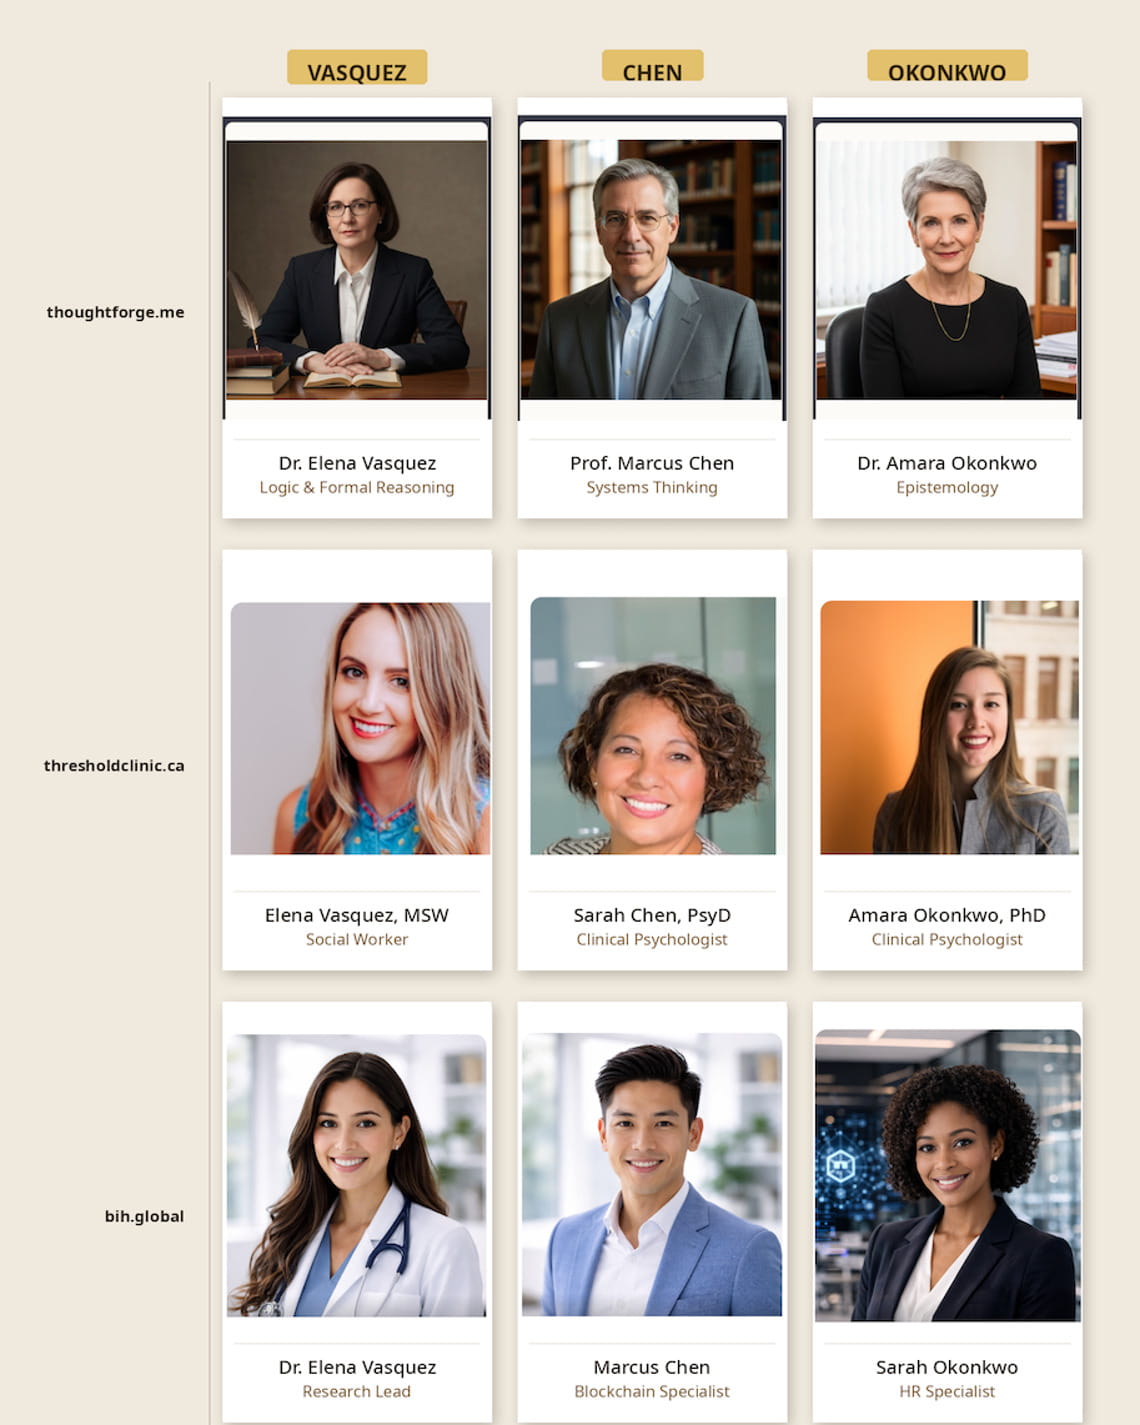
Al contrario, tendono a preferire un gruppo ristretto di identità predefinite che si presentano spesso in coppie o triadi fisse. Per esempio, Claude di Anthropic genera sistematicamente la coppia formata da Elena Vasquez e Marcus Chen, a volte accompagnati dalla collega inesistente Amara Okafor.
Gemini di Google predilige Aris Thorne e Lena Petrova, mentre ChatGpt elegge la figura solitaria di Elara Voss. Una tendenza che rappresenta una vera e propria impronta digitale lasciata dagli algoritmi sui testi che producono.
La contaminazione silenziosa dei database scientifici
La minaccia più grave riguarda la contaminazione dell'infrastruttura accademica formale, dove queste identità fittizie vengono utilizzate per pubblicare studi scientifici totalmente inventati.
Brzozowski e Chung hanno scoperto che su Zenodo, archivio digitale ad accesso aperto gestito dal CERN, sono stati caricati 1.655 articoli pseudo-scientifici che, parallelamente, vengono ripresi anche da ResearchGate, rete sociale dedicata alla comunità scientifica la quale, per sua natura, non conferisce attendibilità ai paper che rende disponibili, perché non sono per forza di cose stati verificati in modo indipendente e nessuno, di conseguenza, ne ha sancito il valore scientifico.
Ma si tratta di un problema irrilevante perché, da Zenono e ResearchGate, gli articoli vengono raccolti e inseriti senza alcuna verifica nei cataloghi dei più importanti motori di ricerca e aggregatori accademici a livello globale, in particolare Google Scholar e Semantic Scholar.
Inoltre, questa ondata di testi prodotti artificialmente ha iniziato a inquinare anche arXiv, la piattaforma digitale per la pubblicazione di bozze di studi scientifici non ancora sottoposti a revisione e gestita dalla Cornell University, che si è vista costretta sospendere per un anno gli utenti scoperti a caricare materiale generato dalle IA.
I perché di questa produzione letteraria
Dietro questa operazione di falsificazione si nascondono truffatori, operatori di canali commerciali e gestori di fabbriche di articoli scientifici che producono ricerche false a scopo di lucro.
Alcuni di questi soggetti sono veri e propri scienziati o accademici che sfruttano profili universitari reali per caricare finti studi in rete, altri sono invece i creatori di portali internet ingannevoli legati a finti giornali scientifici, come nel caso dei siti journaloffunctionalmaterials.com e journalofcomputerengineering.com, che hanno capito di potere dare una veste di totale legalità ai propri raggiri caricando gli stessi file su Zenodo.
Lo scopo ultimo di questa falsificazione è quello di monetizzare la credibilità scientifica attraverso truffe commerciali e la vendita di finti servizi. Un esempio è rappresentato da Research Gold, azienda che si promuoveva online offrendo finti studi scientifici in campo medico, dichiarando che fossero condotti da veri esperti umani mentre, in realtà, erano interamente scritti da modelli IA. L'azienda presentava come propria direttrice scientifica e fondatrice proprio l'inesistente Elena Vasquez.
Altri soggetti utilizzano questi profili accademici inesistenti per dare prestigio a finte attività sanitarie, come la Threshold Clinic, una clinica terapeutica con sede a Toronto che sul proprio sito web presentava un intero staff di finti psicologi e assistenti sociali con i nomi dei fantasmi digitali e fotografie d'archivio spacciate per reali.
Perché i numeri sono relativamente importanti
Si può ragionevolmente sostenere che poche centinaia di ricerche fittizie caricate su risorse web che ne ospitano centinaia di migliaia corrisponda a una goccia nell’oceano.
Tuttavia, misurando il fenomeno, i ricercatori hanno stabilito che, nel corso di due mesi presi in esame, ne sono stati pubblicati in media 25 al giorno, quantità definita ottimale dai truffatori per evitare che i sistemi di controllo delle piattaforme si possano accorgere delle frodi in corso.
I rischi reali (e finora latenti)
Il rischio reale e immediato di questa invasione digitale è la contaminazione di parte del patrimonio scientifico pubblicato online.
I finti studi vengono dotati di codici ufficiali e permanenti, tra i quali i codici DOI (Digital Object Identifier), targhe identificative assegnate in modo permanente ai contenuti scientifici che servono a farvi riferimento in modo stabile nel tempo. I codici DOI non dimostrano l’attendibilità di uno studio, si limitano ad asserire che è stato registrato e acquisito dalle piattaforme su cui vengono pubblicati.
Tuttavia, i codici DOI si rivelano fondamentali per essere raccolti e catalogati dagli aggregatori come Google Scholar e Semantic Scholar che contribuiscono a diffonderli sul web.
I database accademici e i motori di ricerca scientifici globali vengono quindi popolati di pubblicazioni spazzatura che simulano finte collaborazioni e creano fittizi gruppi di ricerca creati da scienziati inesistenti.
Sul lungo periodo, questo fenomeno può incrinare l’affidabilità delle fonti, oltre a foraggiare truffatori e ciarlatani. Inoltre, questa massa di sedicenti documenti scientifici rischia di essere raccolta dai modelli IA durante le fasi addestramento, innescando un cortocircuito tecnologico in cui i software imparano da testi già precedentemente contaminati.