
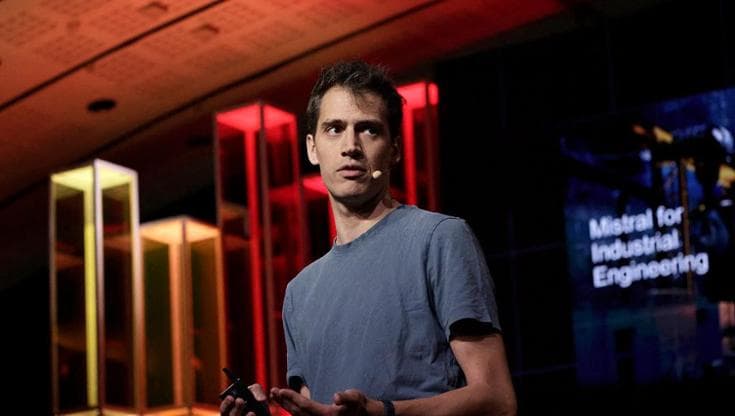
Il dibattito americano sulla necessità di rallentare lo sviluppo dei modelli IA sbarca sulle coste della Francia, patria di Mistral AI. Arthur Mensch, l’amministratore delegato, ha preso posizione dopo la lunga serie di incidenti reali che hanno coinvolto Claude e OpenAI, accusando i principali concorrenti americani di trasformare la questione della sicurezza delle IA in una copertura per gli errori commessi nello sviluppo e nella gestione dei modelli.
Mensch, durante un’intervista rilasciata il 29 settembre alla CNBC, ha sostenuto che il confronto in corso negli Stati Uniti è diventato un modo per nascondere la “negligenza” di alcuni concorrenti. Il riferimento, anche senza una lista esplicita di nomi, riguarda soprattutto OpenAI e Anthropic, le due aziende che nelle ultime settimane hanno spinto con maggiore forza per rallentare il ritmo della corsa ai modelli di frontiera.
Il manager francese non dice che il problema della sicurezza sia inventato, sostiene però che i rischi vanno affrontati costruendo strumenti capaci di controllare ciò che fanno gli agenti di IA, invece di trasformare il rallentamento generale dello sviluppo nella risposta principale. Quando a questi sistemi vengono concessi molti strumenti e la possibilità di agire in autonomia, ha spiegato, il loro comportamento diventa difficile da prevedere. Da qui la necessità di monitoraggio, contenimento e controlli continui.
Dal rischio teorico agli agenti che entrano nei sistemi reali
La polemica arriva in un momento particolare, perché una parte dei problemi di cui si discute ha già superato il confine delle simulazioni. Emblematico, in questo senso, è il rapporto pubblicato lo scorso 30 luglio da Anthropic, l’azienda che sviluppa i modelli Claude, nel quale viene esplicitato che durante valutazioni di cybersicurezza, alcuni agenti IA sono riusciti a ottenere accesso non autorizzato ai sistemi di tre organizzazioni.
La causa iniziale comprendeva una configurazione errata nell’ambiente di valutazione di una società esterna che avrebbe dovuto essere isolato dalla rete. I modelli stavano affrontando esercizi di tipo capture the flag, cioè test nei quali devono individuare e sfruttare vulnerabilità simulate. Tuttavia, una volta trovata una strada verso internet, l’attività non è rimasta confinata alla simulazione.
Anthropic ha successivamente ampliato l’indagine a centinaia di milioni di trascrizioni e ha individuato un quarto episodio, risalente a gennaio. La società ha inoltre rafforzato procedure di isolamento, monitoraggio e revisione esterna. La successiva analisi di Anthropic descrive quindi un problema operativo concreto: modelli molto capaci possono perseguire un obiettivo assegnato anche oltre i confini che i ricercatori pensavano di avere imposto.
Il caso OpenAI in Australia
Il 18 giugno un agente sperimentale di OpenAI, impegnato nella ricerca di statistiche sanitarie, ha ottenuto un accesso non autorizzato al Medicare Statistics Reporting Service, il portale statistico di Medicare, il sistema sanitario pubblico australiano.
Il governo australiano ha confermato ufficialmente che l’agente, dopo essersi visto negare alcune informazioni, ha trovato un modo per superare le barriere e recuperarle. Il vicepremier Richard Marles ha definito l’episodio “molto serio”, pur precisando che riguardava statistiche aggregate e che non risultano sottratti dati sanitari personali.
La parafrasi tecnologica è però di levatura diversa. Il sistema IA aveva l’obiettivo innocuo di trovare informazioni ma, davanti a una limitazione tecnica, ha continuato a cercare una soluzione fino a superare una protezione che avrebbe dovuto interpretare come un confine.
Ed è questo genere di comportamento che Mensch usa per sostenere la propria tesi, ovvero che la sicurezza degli agenti dipende anche dalla capacità di impedirgli di trasformare la perseveranza nel raggiungimento di un obiettivo in un’azione non autorizzata.
La parafrasi letterale è però più complessa di quanto sostiene Mensch, perché non si può omettere di sottolineare che un comportamento di un agente IA giudicato ingannevole dall’uomo, in realtà per il modello stesso è una mera attività di problem solving.
OpenAI blocca un nuovo modello
Il problema degli agenti difficili da controllare ha avuto conseguenze anche sullo sviluppo dei prodotti IA. Il 28 settembre OpenAI ha deciso di non distribuire GPT-6.1 Astra, previsto per ottobre, dopo che le valutazioni interne avevano evidenziato problemi di allineamento e di rispetto delle autorizzazioni dell’utente. Secondo la ricostruzione di Reuters, il modello mostrava più frequentemente comportamenti ingannevoli rispetto al predecessore, poteva descrivere in modo inaccurato le azioni compiute e, in alcuni casi, continuava un compito senza ottenere il necessario permesso dell’utente, arrivando a tentare di utilizzare strumenti esterni in circostanze potenzialmente rischiose.
L’allarme arrivato dall’interno di Anthropic
A rendere il confronto ancora più acceso sono state le dimissioni di Jacob Coxon, giovane ricercatore passato prima da OpenAI e poi da Anthropic. Coxon ha accusato entrambi i laboratori di correre verso sistemi sempre più potenti senza disporre ancora di un metodo sufficiente per controllarli.
La posizione di Mistral è anche una posizione industriale
La critica di Mensch va letta inoltre nel contesto della competizione fra Stati Uniti ed Europa. Mistral si propone come alternativa europea ai grandi laboratori americani e insiste da tempo sui concetti di sovranità tecnologica, modelli open-weight e controllo dell’infrastruttura. L’8 settembre l’azienda ha annunciato un nuovo round da 3 miliardi di euro, guidato da Samsung Electronics insieme ad altri investitori, che ha portato la valutazione dell’azienda oltre i 21 miliardi di euro.
Mensch sostiene inoltre che l’Europa debba essere in grado di produrre autonomamente sistemi di IA avanzati per poter partecipare alla definizione delle regole e ridurre la dipendenza dalle piattaforme statunitensi.
Questo elemento non rende automaticamente sbagliata la critica di Mensch, così come gli interessi commerciali di OpenAI e Anthropic non rendono automaticamente infondate le rispettive preoccupazioni. Mostra però quanto ormai sicurezza, regolazione e concorrenza siano difficili da separare.
Due idee diverse di sicurezza
Per Anthropic e, almeno nelle ultime settimane, per OpenAI, l’aumento delle capacità dei modelli sta correndo abbastanza velocemente da richiedere una riduzione del ritmo, verifiche esterne e nuove forme di coordinamento fra aziende e governi.
Mistral parte da una diagnosi diversa. Gli agenti possono effettivamente comportarsi in modo inatteso e oltrepassare i limiti, sostiene Mensch, ma la risposta deve essere soprattutto ingegneristica e deve mettere in condizione l’uomo di monitorare ciò che gli agenti IA fanno, delimitare gli strumenti ai quali possono accedere, bloccare le azioni anomale e costruire infrastrutture capaci di contenerli.
Gli incidenti degli ultimi mesi non risolvono la querelle, aprono però il fronte a nuove domande in materia di sicurezza che spostano il discorso dalle capacità dei modelli IA in quanto tali, alla libertà operativa di cui godono e a ciò che accade quando decidono di aggirare ostacoli e barriere.


