
29 secondi di trattamento Ludovico e un braccio robotico può apprendere un compito manuale.
Un gruppo di ricercatori cinesi, evocando quasi Arancia Meccanica, ha costretto una piattaforma robotica (dotata del suo software Host, acronimo di Human-to-robot One-Shot Skill AcquisiTion) all’osservazione di un video esplicativo di un’azione da compiere.
Un’unità bimanuale allestita con due bracci ARX R5, senza alcun aggiornamento dei parametri del modello IA, ha replicato ogni movimento.
Come spiega la ricerca firmata dagli specialisti della Beijing Institute of Technology, di X Square Robot e della Tsinghua University, la chiave di volta è nel metodo di apprendimento robotico.
Normalmente i sistemi attuali acquisiscono nuove abilità attraverso un ciclo di addestramento lungo e costoso: un operatore raccoglie decine di dimostrazioni tramite teleoperazione, poi il modello viene sottoposto a un nuovo ciclo di affinamento che può richiedere ore. Il problema, spiegano gli autori, non è solo la lentezza.
Ogni volta che i parametri condivisi del modello vengono aggiornati per imparare un compito nuovo, le abilità già acquisite tendono a deteriorarsi, un fenomeno noto come catastrophic forgetting.
Host elimina questo ciclo spostando l'apprendimento dalla fase di addestramento a quella di inferenza. Il robot non modifica mai i propri parametri: osserva un video umano, lo interpreta e agisce di conseguenza, mantenendo intatte tutte le competenze precedenti.
Come funziona realmente
Il sistema lavora attraverso una sequenza di tre passaggi, ispirata al modo in cui gli esseri umani osservano e imitano un gesto altrui. Prima localizza in quale punto della procedura dimostrata si trova il robot, poi traduce la fase successiva del video in osservazioni future previste per il robot stesso, infine deriva le azioni concrete da compiere a partire da quelle osservazioni.
Un focus del metodo è l'allineamento tra il video dimostrativo e la traiettoria del robot: i due flussi, nella realtà, si svolgono a velocità diverse, quindi il sistema deve capire quale fotogramma del video corrisponde a quale istante dell'azione del robot.
Host risolve il problema misurando quanto ciascun fotogramma è avanzato nel compito, su una scala da 0 (inizio) a 1 (completamento), appresa in modo autosupervisionato, anziché limitarsi a far coincidere i fotogrammi in base al tempo trascorso.
Prestazioni da primato, soprattutto per l’efficienza
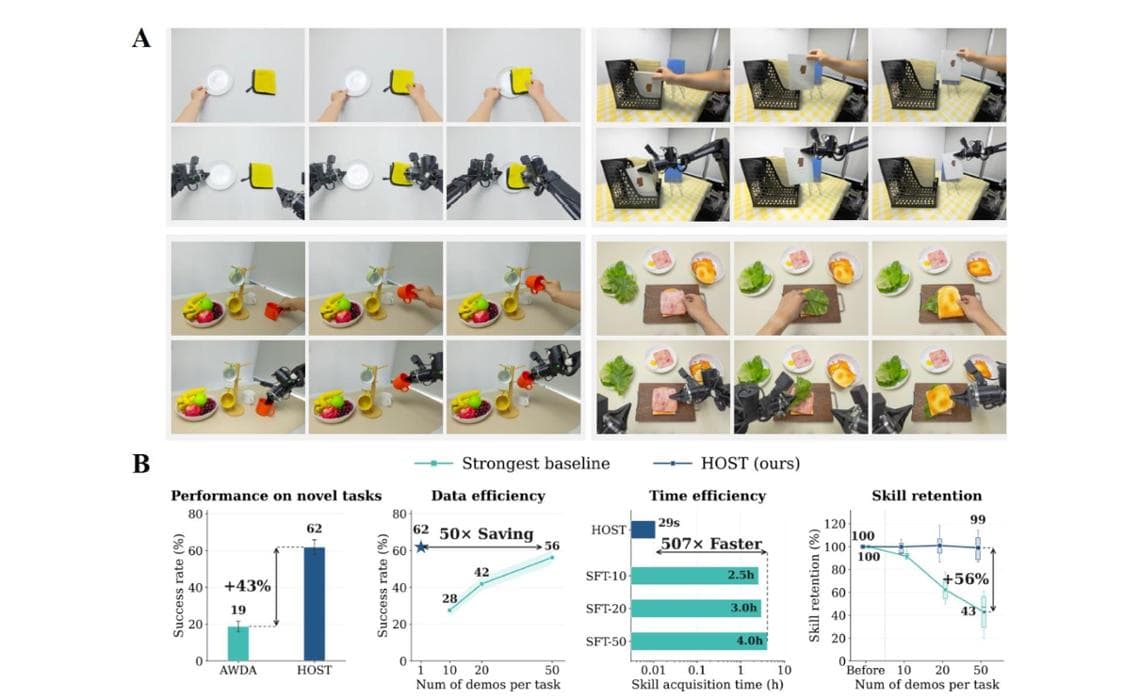
Gli esperimenti sono stati condotti su una piattaforma bimanuale con due bracci robotici della cinese ARX Robotics (da non confondere con l’omonima tedesca), ciascuno dotato di pinza e osservato da tre telecamere RGB. Su un set di 50 compiti manuali mai visti durante l'addestramento, Host raggiunge in media un tasso di successo del 62%, superando del 45% le migliori tecniche di apprendimento basate su istruzioni testuali e del 43% i metodi di imitazione da video a singola dimostrazione già esistenti.
Il confronto più significativo riguarda però l'efficienza. Rispetto a un modello sottoposto a 50 dimostrazioni per compito, che richiede fino a circa 5 ore di lavoro tra raccolta dati e addestramento, Host acquisisce la stessa abilità da un solo video in una media di 29 secondi, quindi utilizzando 50 volte meno dimostrazioni e acquisendo l’abilità 507 volte più rapidamente, pur ottenendo un tasso di successo superiore.
Sul fronte della ritenzione delle competenze, i ricercatori hanno misurato le prestazioni su sette compiti già appresi prima e dopo l'acquisizione di un'abilità nuova. I modelli tradizionali perdono fino all'80% delle loro capacità originarie, mentre Host le mantiene pressoché invariate, con scarti riconducibili alla normale variabilità tra le prove.
Il sistema si è dimostrato inoltre relativamente robusto a variazioni dell'ambiente di lavoro: la perdita di prestazioni resta contenuta all'1% in caso di cambi di illuminazione, sale al 4% con oggetti mai visti, al 6% con un cambio di scena e al 9% quando una persona sposta fisicamente un oggetto durante l'esecuzione del compito.
Un campo di ricerca affollato
Host non nasce in un vuoto competitivo. Lo stesso studio lo confronta direttamente con due sistemi della stessa famiglia, la cosiddetta one-shot visual imitation, cioè l'apprendimento da un'unica dimostrazione video senza aggiornamento dei parametri.
Il primo è Vid2Robot, sviluppato da Google DeepMind Robotics insieme alla Carnegie Mellon University, che utilizza livelli transformer ad attenzione incrociata per condizionare le azioni del robot su un video dimostrativo umano; secondo gli autori originali del sistema, Vid2Robot ottiene un miglioramento superiore al 20% rispetto al modello di riferimento BC-Z quando riceve un video umano come prompt. Il secondo, Awda, è citato come ulteriore termine di paragone. Su questi stessi compiti, gli autori di Host sostengono che il proprio framework superi Vid2Robot del 43%, pur ricevendo lo stesso identico video in input.
Il resto del panorama affronta un problema in parte diverso: non l'acquisizione istantanea di un singolo compito a partire da un video, ma la costruzione di modelli fondazionali generalisti che incorporano grandi quantità di video umani già nella fase di addestramento.
Nvidia ad esempio ha rilasciato in primavera la versione N1.7 del proprio modello GR00T, basata su un nuovo componente chiamato EgoScale: secondo il blog tecnico dell'azienda, il modello è stato pre-addestrato su oltre 20mila ore di video egocentrici umani, cioè girati in prima persona con telecamere indossate, relativi a più di venti categorie di compiti.
L’azienda sostiene di aver individuato quella che definisce la prima legge di scala per la destrezza robotica, secondo cui l'aumento del volume di questi video da mille a ventimila ore raddoppia circa il tasso medio di completamento dei compiti; anche in questo caso si tratta di un dato riportato dall'azienda stessa, non verificato da terze parti.
La differenza sostanziale tra questi approcci e Host sta quindi nel momento in cui avviene l'apprendimento. Nvidia punta su un pre-addestramento sempre più ampio, capace di generalizzare a compiti nuovi senza ulteriori dati; Host, al contrario, rivendica l'assenza totale di aggiornamento dei parametri anche nella fase di acquisizione della nuova abilità, spostando l'unico requisito aggiuntivo alla semplice registrazione di un video.
Un archivio di gesti da riutilizzare
Un'ultima caratteristica del sistema riguarda la persistenza delle abilità acquisite. Ogni video dimostrativo può essere salvato e recuperato automaticamente quando lo stesso compito si ripresenta, senza bisogno di un nuovo intervento umano: il robot costruisce così, nel tempo, un archivio di competenze riutilizzabili.
Gli stessi autori indicano però dei limiti. Il sistema è stato testato finora su un'unica piattaforma robotica bimanuale e non è ancora stato verificato su corpi robotici sostanzialmente diversi. Inoltre i video dimostrativi non catturano le forze di contatto necessarie per le manipolazioni più fini, un aspetto che i ricercatori indicano come direzione di sviluppo futuro, ad esempio tramite guanti tattili indossabili.


